REX | Trouver la combinaison optimale d'une lineup sous un budget limité
Pour dire à un joueur de fantasy football si sa lineup est forte, il faut un étalon : la meilleure lineup possible sous un budget limité (le cap). Une recherche de combinaison optimale, avec des pièges Go à la clé.
/7 min de lecture
En 2024, chez SorareData, un outil d’aide aux joueurs de Sorare (un jeu de fantasy football), on m’a posé un joli problème d’algorithmique. Le principe du jeu : on compose une lineup de 5 joueurs à partir de cards qu’on possède, et la lineup marque des points selon les matchs réels.
Notre outil, le lineup builder, aidait à composer la lineup et affichait pour chaque joueur un score attendu.
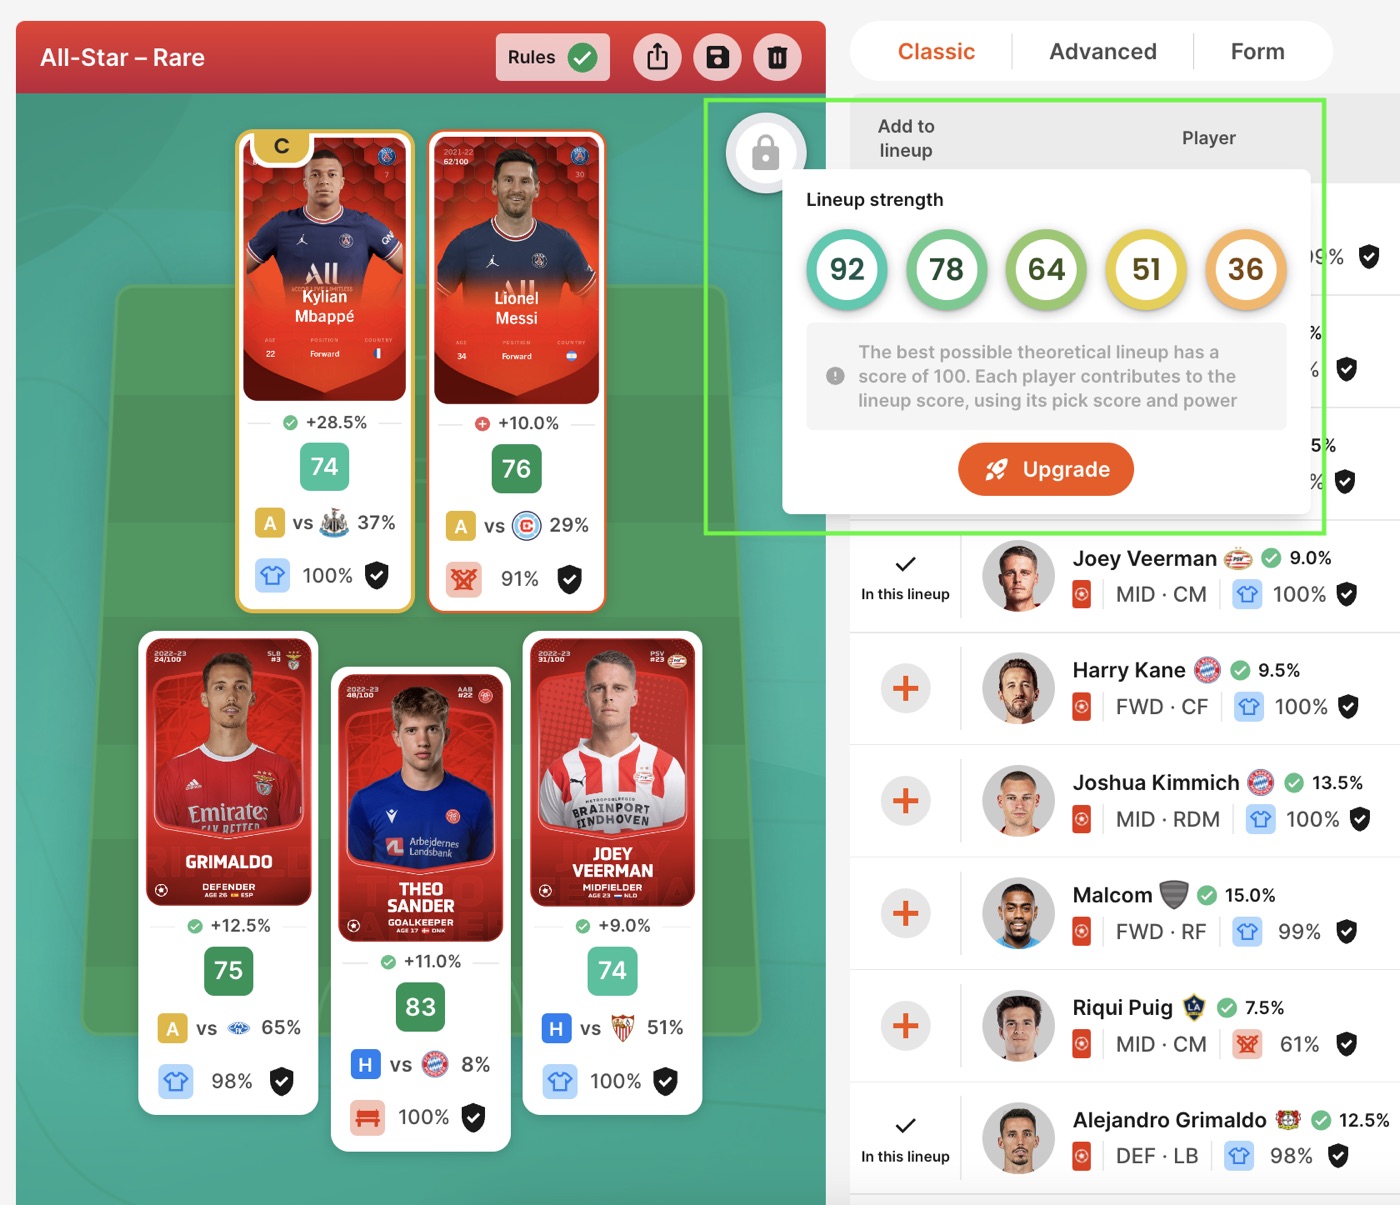
Une question revenait tout le temps : « ma lineup vaut 150 points attendus, c’est bien ? » Sans point de comparaison, impossible de répondre.
Un étalon : la meilleure lineup possible
L’idée : calculer, pour chaque compétition, le score maximal théorique, puis exprimer une lineup en pourcentage de ce maximum. C’est ce qu’on a appelé la lineup strength (la force de la lineup).
Lineup à 150 points, maximum de la compétition à 183 → strength de 82 %.
Le résultat s’affiche sous forme de pastille colorée, de « terrible » (rouge) à « excellent » (vert) :
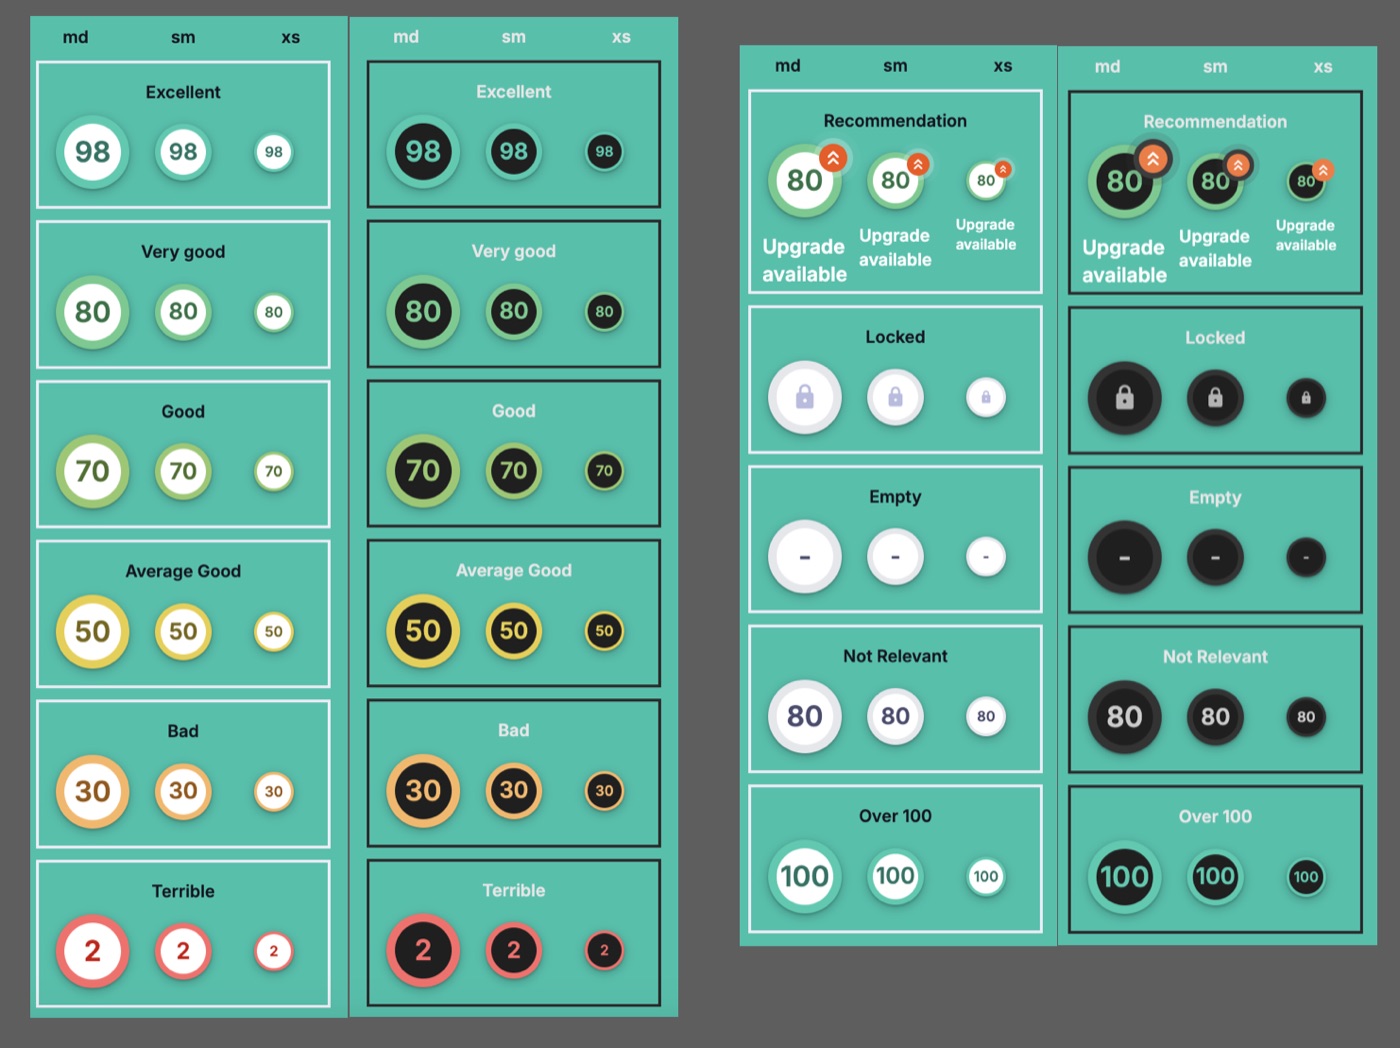
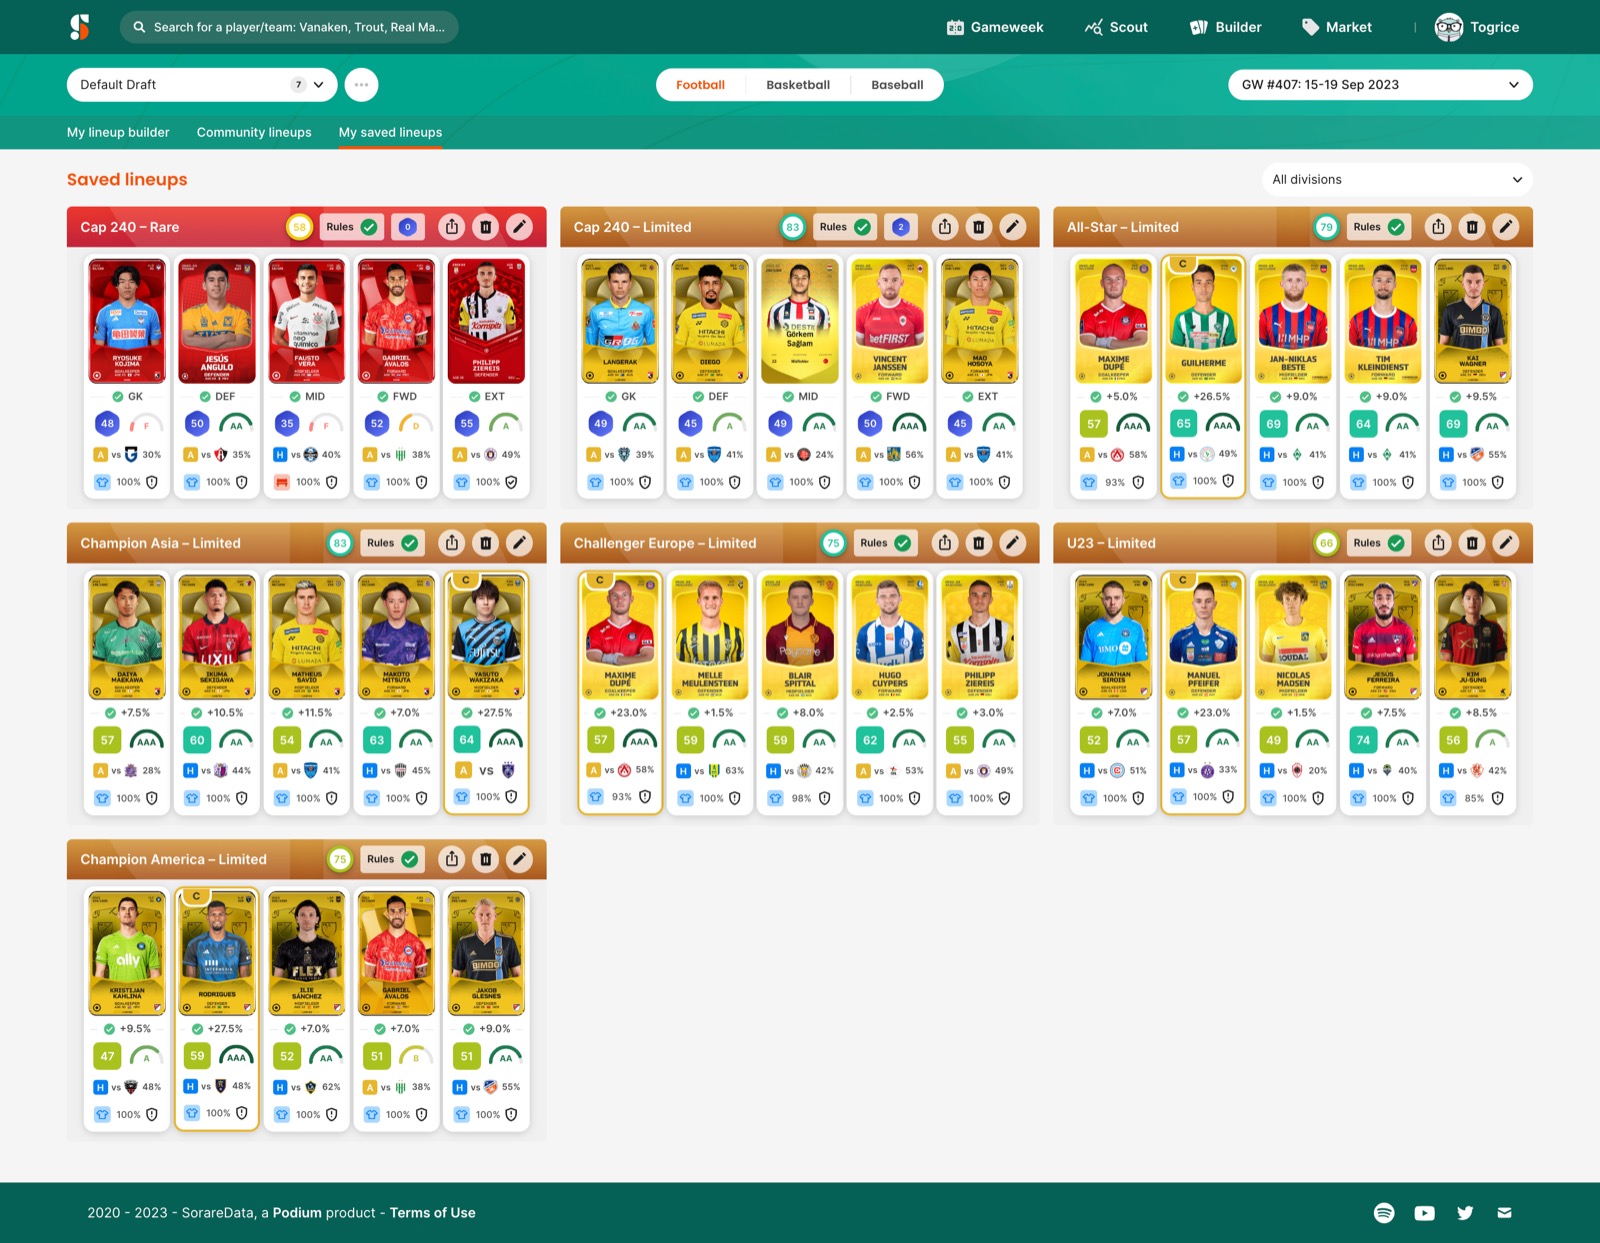
Le pourcentage du maximum ne suffit pas à lui seul pour fixer les seuils : 70 % peut être excellent sur une compétition et banal sur une autre. Les niveaux de la pastille sont donc calés sur ce que les autres joueurs ont réellement aligné (la médiane, les 10 % les plus faibles et les 10 % les plus forts). C’est ce qui permet de dire « ta lineup est dans le haut du panier ». Ces pastilles apparaissent aussi sur la page des saved lineups :
Reste à calculer ce maximum.
Cas facile : pas de cap
Chaque joueur a un score attendu. Sans contrainte, on prend simplement le meilleur de chaque poste. Une boucle suffit.
Cas difficile : un cap de coût
Certaines compétitions (capped) limitent la somme des « coûts » des joueurs. Or les meilleurs joueurs sont aussi les plus chers. Il faut arbitrer.
Prenons un exemple minuscule : 3 postes, 3 candidats par poste, un cap de 25.
| Poste | Candidat | Score | Coût |
|---|---|---|---|
| Goalkeeper | G1 | 60 | 10 |
| G2 | 55 | 6 | |
| G3 | 40 | 3 | |
| Defender | D1 | 70 | 12 |
| D2 | 62 | 8 | |
| D3 | 45 | 4 | |
| Forward | F1 | 80 | 14 |
| F2 | 66 | 9 | |
| F3 | 50 | 5 |
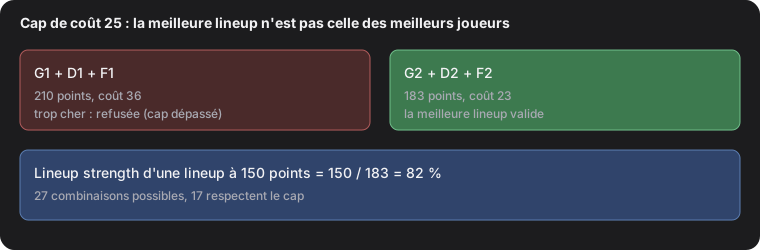
- Sans cap : G1 + D1 + F1 = 210 points, mais coût 36. Interdit.
- Avec un cap de 25 : la meilleure lineup est G2 + D2 + F2 = 183 points pour un coût de 23.
La meilleure lineup n’est pas celle des meilleurs joueurs. Sur les 27 combinaisons possibles, seules 17 respectent le cap.
C’est une variante d’un problème classique, le sac à dos à choix multiples : un objet à choisir par groupe (ici un joueur par poste), sous une contrainte de poids (ici le cap).
Première idée : tout essayer
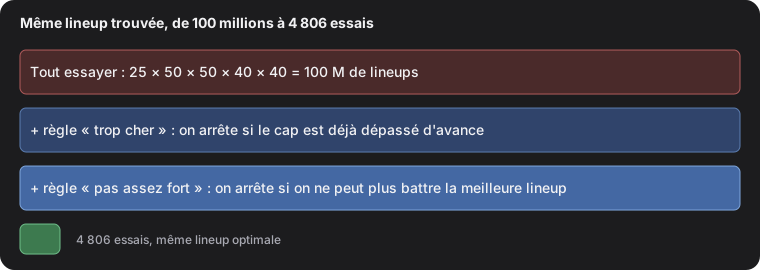
Avec 3 postes, on teste 27 combinaisons à la main. La vraie compétition compte des centaines de joueurs par poste. On ne garde donc que les 25 à 50 meilleurs candidats par poste. C’est une approximation assumée : le résultat est optimal sur ce sous-ensemble, pas sur tous les joueurs. Sur 5 postes, cela donne 25 × 50 × 50 × 40 × 40, soit 100 millions de lineups. Un ordinateur sait le faire, en environ une seconde.
Go invite à utiliser ses channels : une goroutine génère les lineups, une autre les évalue, reliées par un channel. C’est élégant, mais j’y ai trouvé deux pièges.
Piège 1 : un slice partagé entre goroutines
Pour construire une lineup poste par poste, on utilise un slice (la liste dynamique de Go). Si on lui réserve d’avance la place de 5 joueurs pour éviter des allocations, toutes les lineups partagent le même tableau en mémoire. Envoyer le slice dans le channel n’envoie pas une copie, juste une fenêtre sur ce tableau.
C’est comme envoyer à quelqu’un le lien d’un document partagé au lieu d’une copie : pendant qu’il le lit, on est déjà en train de le réécrire pour la lineup suivante.
cur := make([]Candidate, 0, 5) // place réservée : le tableau est partagé
// ...
combos <- cur                  // le générateur réécrit cur juste après
// correction : on envoie une copie
combos <- append([]Candidate(nil), cur...)
go test -race le signale tout de suite. Sans la réservation (le slice démarre petit et grossit), Go réalloue en cours de route et, avec 5 joueurs, chaque lineup finit par hasard dans son propre tableau. Ce n’est pas une garantie, juste un effet de la façon dont Go fait grossir les slices. Le piège apparaît donc justement quand on « optimise ». Et on ne peut pas se fier à un test qui passe : la corruption dépend du timing, seul -race la détecte à coup sûr.
Une remarque : un vrai tableau [5]Candidate est copié à l’envoi, donc sûr. C’est le slice qui trompe.
Piège 2 : un channel coûte cher pour un petit travail
Même corrigé, le pipeline est environ 8 fois plus lent que de simples boucles imbriquées sur ma machine (115 ms contre 14 ms sur un jeu réduit de 1,2 million de lineups). Chaque envoi dans un channel coûte une synchronisation, alors que le travail utile est minuscule : additionner 5 nombres.
Les channels sont parfaits pour passer des tâches substantielles. Pour des millions de micro-tâches, mieux vaut des boucles, ou envoyer des lots plutôt qu’un élément à la fois.
Mieux : ne pas tout essayer
Quand on construit une lineup poste par poste, on peut s’arrêter dès que ça ne sert plus à rien. C’est le principe du branch and bound (séparation et évaluation). Deux règles de bon sens :
- Trop cher. Si le coût déjà engagé, plus le coût du moins cher possible pour les postes restants, dépasse le cap, on abandonne.
- Pas assez fort. Si le score actuel, plus le meilleur score imaginable pour les postes restants, n’atteint pas la meilleure lineup déjà trouvée, on abandonne aussi.
Dans l’exemple : commencer par G1 (coût 10) puis D1 (coût 12) fait 22. Il faut encore un Forward, au minimum 5. Total 27 > 25 : inutile d’essayer les Forwards, on passe à la suite.
Pour que ce soit rapide, on précalcule une seule fois, pour chaque poste, « le meilleur score restant » et « le coût minimal restant ». Et on trie les candidats du meilleur au moins bon : dès qu’un candidat est trop faible, tous les suivants le sont aussi, on sort de la boucle.
for _, c := range candidates[pos] {
	if cost+c.Cost+minCostLeft[pos+1] > budget {
		continue // trop cher, un suivant moins cher peut passer
	}
	if score+c.Score+maxScoreLeft[pos+1] <= best.Score {
		break // trop faible, et les suivants sont encore plus faibles
	}
	// ... on avance au poste suivant
}
Remarquez la différence entre continue (ce candidat est trop cher, le suivant est peut-être moins cher) et break (la liste est triée, tout le reste est pire).
Les résultats
Mesurés sur un prototype avec des données aléatoires, aux vraies tailles :
| Méthode | Temps | Lineups examinées |
|---|---|---|
| Tout essayer | ~917 ms | 100 000 000 |
| Avec élagage | ~77 µs | 4 806 |
Environ 12 000 fois plus rapide, avec exactement la même lineup. Je l’ai vérifié en gardant la version « tout essayer » comme référence dans les tests : lente mais évidente, elle valide la version rapide sur 20 jeux de données et plusieurs caps.
J’ai aussi essayé de répartir le travail sur 4 goroutines. Résultat : 10 fois plus lent. Avec seulement quelques milliers de cas, se synchroniser coûte plus que de calculer. Mesurer avant de paralléliser.
Une alternative classique aurait été la programmation dynamique sur le coût (meilleur score atteignable pour chaque budget, poste par poste). Elle fonctionne bien quand les coûts sont des entiers de petite taille. Ici, l’élagage suffisait largement.
Ce que j’en retiens
- Un chiffre seul ne parle pas : il faut un étalon (ici le score maximal) pour le rendre lisible.
- Mesurer avant de choisir : sur du travail très fin, un channel par élément ou des goroutines supplémentaires ont coûté 8 à 10 fois plus que de simples boucles.
- Passer un slice à une autre goroutine, c’est partager sa mémoire : copier, ou laisser
-racevérifier. - Pour un problème de choix sous contrainte, deux bornes précalculées éliminent presque tout.
- Garder la force brute comme référence de test permet d’optimiser sans crainte.
- Réduire le problème (les N meilleurs candidats par poste) est une approximation à assumer explicitement.